
Blog · Gestionale
Anagrafiche prodotti pulite: checklist operativa per gestori
Per ottenere anagrafiche prodotti pulite oggi stesso, esegui tre azioni: fai un backup completo del database, esporta gli identificativi univoci (SKU, EAN, ID interno) e lancia una prima deduplicazione con regole conservative, che segnalano i sospetti senza cancellare nulla in automatico. Con dati puliti le ricerche interne diventano più veloci, le integrazioni con e‑commerce e marketplace smettono di generare errori, e la reportistica torna affidabile.
Prima di lanciare qualsiasi script, verifica questi tre punti:
- SKU ed EAN sono compilati e univoci per ogni articolo, comprese le varianti.
- I prodotti padre e le loro varianti sono collegati correttamente, non duplicati come record indipendenti.
- Le colonne essenziali (nome, categoria, unità di misura, prezzo) hanno un formato coerente in tutto il catalogo.
Un’anagrafica prodotti pulita non è un progetto che si chiude: è un processo che va governato, con ruoli chiari e regole di importazione che impediscono ai duplicati di ricrescere.
Se il catalogo supera qualche migliaio di articoli o gestisci più canali di vendita, la sezione dedicata al supporto operativo più avanti spiega come Linkware affianca chi preferisce delegare l’intervento a un tecnico esperto.
Punti chiave
Anagrafiche prodotti pulite si ottengono con un identificativo univoco per record, regole di deduplicazione testate su campione e una governance che impedisce nuove duplicazioni nel tempo.
| Punto | Dettagli |
|---|---|
| Backup prima di tutto | Nessuna pulizia o dedup va lanciata senza una copia di sicurezza verificata e ripristinabile. |
| Identificativo univoco al centro | SKU ed EAN devono essere completi e coerenti prima di qualsiasi confronto tra record. |
| Match deterministico prima del fuzzy | Confronta prima EAN e SKU esatti, poi passa al fuzzy matching con revisione manuale. |
| Un solo sistema autorevole | L’anagrafica nasce nell’ERP e si replica a valle, mai il contrario. |
| Supporto specializzato per cataloghi complessi | Linkware affianca assessment, dedup e integrazione PIM/ERP con un referente unico dedicato. |
Indice
- Checklist rapida per iniziare oggi
- Preparazione: backup, esportazione e mappatura dei file
- Standardizzare i campi prima di confrontare i dati
- Deduplicazione: tecniche di confronto e strumenti pratici
- Regole sicure per unire record e conservare lo storico
- Quando conviene arricchire i dati con un PIM
- Governance operativa: ruoli e processi per non tornare al caos
- Test, rollout e stima dei tempi
- Come gestire le anagrafiche clienti insieme a quelle prodotto
- Come validare i dati dopo la pulizia
- Automatizzare la pulizia senza perdere il controllo
- Come scegliere un software o un consulente per la pulizia dati
- Aggiornare le anagrafiche nel tempo senza ricreare il problema
- Supporto operativo: come Linkware può aiutarti
- Fonti
Checklist rapida per iniziare oggi
Prima di sera puoi aver già ridotto in modo visibile il rumore nell’anagrafica. Segui questo ordine:
- Esporta l’intero catalogo in un file separato, da conservare come copia di sicurezza intoccabile.
- Genera un elenco di soli SKU/EAN e verifica quanti valori sono vuoti o ripetuti.
- Crea un CSV minimale con le sole colonne critiche (identificativo, nome, categoria).
- Applica standardizzazioni rapide: elimina spazi doppi, uniforma maiuscole/minuscole nei codici.
- Segna a parte i casi dubbi (varianti simili, nomi quasi identici) per un controllo manuale.
Un consiglio: quando importi in massa, carica solo le colonne che vuoi modificare. Un file con troppi campi rischia di sovrascrivere dati corretti con valori vuoti, un errore comune che vanifica ore di lavoro.
Con un catalogo di media dimensione, in poche ore emerge di solito una quota di duplicati sufficiente a giustificare un intervento strutturato.
Preparazione: backup, esportazione e mappatura dei file
Il primo passo non è tecnico, è precauzionale: nessuna pulizia di anagrafiche prodotti pulite parte senza un backup verificato e ripristinabile. Dopo il backup, esporta solo i campi che ti servono per il controllo: identificativo univoco, descrizione breve, categoria, attributi critici (taglia, colore, unità di misura).
La mappatura tra colonne del file e campi del gestionale è il punto dove si annidano più errori di importazione. Rispettare il tracciato record richiesto dalla piattaforma, comprese le codifiche multiple come EAN e codice interno, evita gran parte degli errori di import.
- Verifica che ogni riga abbia un identificativo, mai una cella vuota nella colonna chiave.
- Controlla che non ci siano due righe con lo stesso EAN ma nomi diversi.
- Salva il file di lavoro separato dall’esportazione originale, così puoi sempre ripartire da zero.
Standardizzare i campi prima di confrontare i dati
Confrontare record scritti in modo diverso produce falsi negativi: il sistema non riconosce come duplicati due prodotti identici solo perché uno ha “Pz.” e l’altro “pz”. La normalizzazione va fatta prima di qualsiasi ricerca di duplicati, non dopo.
Applica queste regole ai campi chiave:
- Nome prodotto: converti tutto in minuscolo per il confronto, rimuovi punteggiatura e spazi multipli.
- Codice prodotto: elimina zeri iniziali superflui e caratteri non alfanumerici incoerenti.
- Unità di misura: mappa le varianti testuali su un set fisso (es. “kg”, “Kg.”, “chilogrammi” diventano tutte “kg”).
- Descrizione: uniforma l’ordine degli attributi (colore, poi taglia, poi materiale) quando è ricorrente.
Un consiglio: applica trasformazioni massicce solo sui campi puramente tecnici. Su descrizioni ricche di informazioni commerciali, meglio un controllo manuale a campione: una normalizzazione troppo aggressiva può cancellare dettagli che servono al marketing o alla logistica.
Deduplicazione: tecniche di confronto e strumenti pratici
La deduplicazione efficace segue una gerarchia precisa: prima i confronti deterministici, poi quelli approssimativi. Un match su EAN è quasi sempre affidabile al 100%, mentre un confronto sui soli nomi prodotto richiede soglie di tolleranza e una verifica umana finale.
Le tecniche principali sono tre:
- Matching deterministico sulle chiavi: confronta EAN o SKU esatti. È il metodo più sicuro, va lanciato per primo.
- Confronto EAN/GTIN incrociato con SKU interno: utile quando lo stesso prodotto ha codici diversi tra fornitore e gestionale.
- Fuzzy matching su nome e categoria: intercetta refusi, abbreviazioni e varianti di scrittura, ma genera più falsi positivi.
Ordine di priorità consigliato per le regole:
- Match su EAN identico → fusione automatica.
- Match su SKU identico con nome simile → fusione automatica.
- Fuzzy match su nome + stessa categoria → revisione manuale prima della fusione.
- Nessun match su identificativi, solo similarità testuale → sempre revisione manuale.
Un consiglio: testa ogni regola su un campione di alcune centinaia di record prima di applicarla a tutto il catalogo. Se il fuzzy matching produce un’alta percentuale di falsi positivi sul campione, aumenta la soglia di similarità prima di procedere sull’intero database.
Distinguere padre e varianti è cruciale qui: due taglie della stessa maglietta non sono duplicati, sono record collegati. Una regola di matching che ignora questa differenza rischia di fondere articoli che devono restare separati per la gestione di stock e prezzi.
Regole sicure per unire record e conservare lo storico
Il merge è l’operazione più delicata: unire due schede prodotto senza criteri chiari significa perdere ordini collegati, giacenze o schede tecniche. Prima di fondere qualsiasi record, stabilisci quale sia il “campo autorevole”, cioè quale versione del dato prevale in caso di conflitto (di solito la più recente o quella del sistema di produzione).
Checklist per un merge sicuro:
- Backup dedicato del sottoinsieme di record coinvolti, prima di ogni fusione.
- Test su un campione ristretto, verificando che ordini e movimenti restino collegati al record superstite.
- Conservazione di un log con i vecchi ID, per rintracciare la cronologia in caso di controlli.
- Priorità esplicita su prezzi, giacenze e attributi multivalore: mai una fusione “a caso” tra due valori diversi.
Un consiglio: prima di fondere due schede, verifica che immagini e schede tecniche restino agganciate al record che sopravvive. Versiona la scheda originale con una nota interna, così chi la ritrova tra sei mesi capisce da dove arriva.
Quando conviene arricchire i dati con un PIM
Con un catalogo di poche centinaia di articoli e un solo canale di vendita, l’ERP gestisce l’anagrafica senza problemi. La soglia cambia quando i canali si moltiplicano: e‑commerce, marketplace, listini B2B in più lingue. A quel punto un Product Information Management centralizza l’arricchimento e riduce gli errori di pubblicazione.
Attività tipiche di arricchimento in un PIM:
- Attribuzione di categorie standard e tassonomie compatibili con i marketplace.
- Gestione centralizzata di immagini, schede tecniche e metadati per canale.
- Traduzione e adattamento delle descrizioni per mercati diversi.
- Pubblicazione automatica verso siti e‑commerce e marketplace, senza doppio inserimento manuale.
Il processo tipico prevede che l’anagrafica nasca nell’ERP con i dati gestionali essenziali, venga arricchita nel PIM con contenuti commerciali, e da lì venga pubblicata verso i canali di vendita. Chi integra un gestionale con Magento conosce bene il rischio di anagrafiche disallineate tra i due sistemi quando questo flusso manca.
Governance operativa: ruoli e processi per non tornare al caos
La pulizia tecnica dura poco se manca un metodo per mantenerla. Le anagrafiche prodotto moderne richiedono ruoli definiti, soprattutto quando servono per requisiti di compliance come il Passaporto Digitale del Prodotto, che impone tracciabilità e validazione del dato lungo tutta la filiera.
Ruoli minimi da assegnare:
- Proprietario del dato: decide gli standard e approva le eccezioni.
- Data steward: esegue i controlli periodici e segnala anomalie.
- Key user di magazzino: verifica coerenza tra fisico e anagrafica.
- Referente e‑commerce: controlla la coerenza dei dati pubblicati online.
- Referente tecnico per integrazioni: gestisce mappature tra ERP e sistemi terzi.
Regola essenziale: l’anagrafica nasce in un solo sistema, l’ERP, e viene replicata a valle. Nessuna modifica diretta sui sistemi secondari, altrimenti il dato si disallinea di nuovo in poche settimane.
Un consiglio: definisci per iscritto quali campi sono “bloccati” fuori dall’ERP. Anche una sola persona che modifica il nome prodotto direttamente sull’e‑commerce può vanificare mesi di pulizia.
Test, rollout e stima dei tempi
Non applicare mai le regole di dedup all’intero catalogo al primo tentativo. Lavora per campioni, misura i risultati, poi allarga la portata.
- Cataloghi piccoli possono richiedere da alcuni giorni a qualche settimana per export, pulizia, dedup e QA.
- Cataloghi medi possono richiedere diverse settimane, con più cicli di test.
- Cataloghi grandi o multicanale possono richiedere più mesi e spesso necessitano di supporto esterno dedicato.
| Fase | Attività principale |
|---|---|
| Export | Estrazione dati e backup |
| Pulizia | Normalizzazione campi |
| Dedup | Matching e revisione |
| Merge | Fusione controllata |
| QA | Controlli post rollout |
Dopo il rollout, misura il tasso di duplicati residui e i tempi medi di ricerca prodotto: sono gli indicatori più diretti del successo dell’intervento.
Come gestire le anagrafiche clienti insieme a quelle prodotto
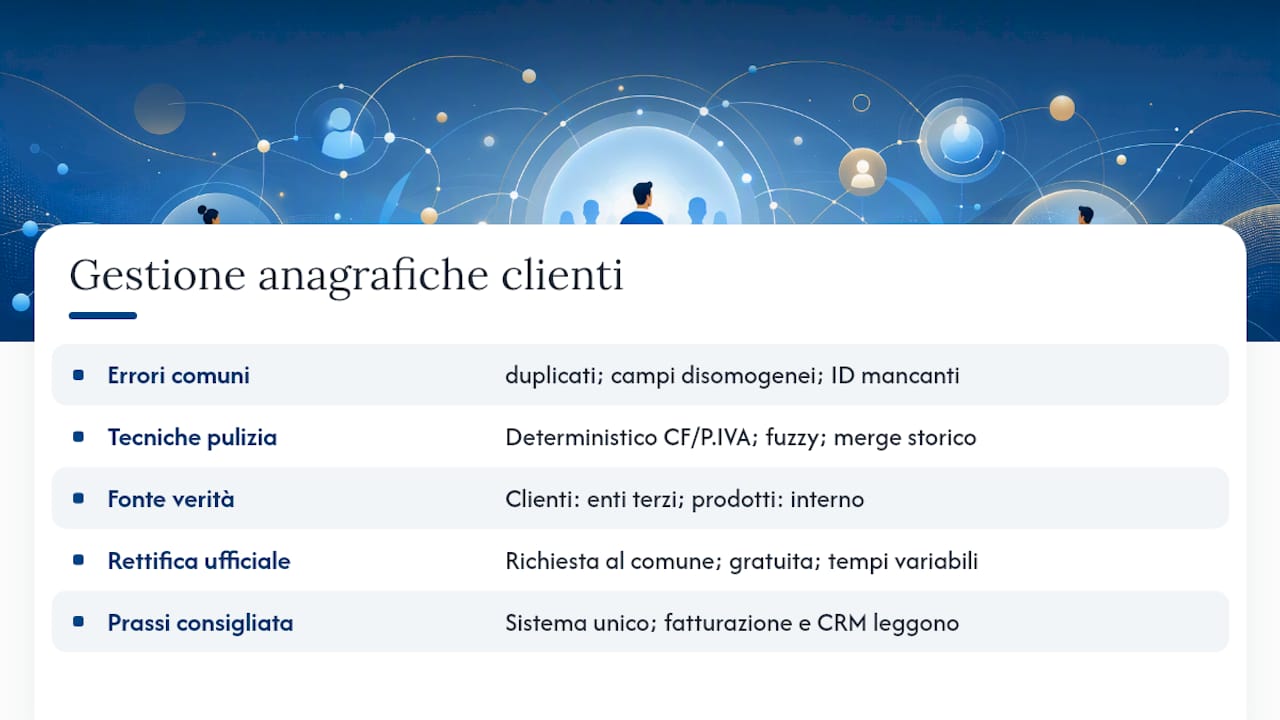
La pulizia del catalogo prodotti non può ignorare l’anagrafica clienti, perché gli stessi errori (duplicati, campi disomogenei, identificativi mancanti) si ripetono identici sul lato anagrafico dei clienti e generano gli stessi problemi a valle: fatture sbagliate, comunicazioni doppie, reportistica di vendita inattendibile.
Le tecniche sono in gran parte le stesse viste per i prodotti: matching deterministico su codice fiscale o partita IVA, fuzzy matching su ragione sociale e indirizzo per intercettare varianti di scrittura, e regole di merge che conservano lo storico ordini. La differenza principale riguarda la fonte della verità: per i clienti, il dato anagrafico spesso deve coincidere con quello ufficiale registrato presso enti terzi.
Quando un cliente segnala un’incongruenza nei propri dati anagrafici personali, esiste una procedura pubblica di correzione: è possibile presentare una richiesta di rettifica al comune di residenza, gestita dall’ufficio anagrafe, gratuita ma con tempi variabili a seconda del carico dell’ente. Questo vale per i dati anagrafici civili, un caso diverso dalla correzione dei dati commerciali nel gestionale, ma è utile saperlo quando un cliente contesta un’informazione che il tuo sistema ha semplicemente ereditato da una fonte esterna non aggiornata.
Nel gestionale, applica la stessa disciplina vista per i prodotti: un solo sistema autorevole per l’anagrafica cliente, con la fatturazione e il CRM che leggono da lì, mai il contrario.
Come validare i dati dopo la pulizia
Pulire non basta se non verifichi che il risultato regga nel tempo. La validazione post pulizia si articola su tre livelli distinti, e confonderli è l’errore più comune tra chi si ferma al primo controllo superficiale.
Il primo livello è la validazione tecnica: formati corretti, campi obbligatori compilati, nessun identificativo duplicato residuo. Si automatizza facilmente con query periodiche sul database.
Il secondo livello è la coerenza di dominio, cioè verificare che il dato abbia senso nel contesto operativo: un prodotto marcato come “attivo” ma senza giacenza da mesi, una categoria assegnata che non esiste più nel listino attuale. Qui serve competenza di settore, non solo controlli automatici, perché la distinzione tra pulizia tecnica e pulizia di dominio richiede attività e ruoli separati per essere efficace davvero.
Il terzo livello è il controllo incrociato con i sistemi collegati: l’anagrafica pulita nell’ERP deve corrispondere esattamente a quella pubblicata sull’e‑commerce, sul marketplace, nei listini condivisi con agenti o rivenditori. Una discrepanza qui vanifica il lavoro fatto a monte.
Pianifica controlli ricorrenti, non solo un audit una tantum: un controllo mensile su un campione casuale di record intercetta i problemi prima che si accumulino, mentre un controllo trimestrale completo verifica la tenuta delle regole di governance nel tempo.
Automatizzare la pulizia senza perdere il controllo
L’automazione ha senso solo dopo aver stabilizzato le regole manualmente. Automatizzare un processo di pulizia ancora incerto significa moltiplicare gli errori invece di eliminarli.
Le automazioni più affidabili riguardano compiti ripetitivi e a basso rischio: normalizzazione automatica di maiuscole e spazi in fase di inserimento, blocco automatico di un nuovo SKU se un EAN identico esiste già, alert quando un campo obbligatorio resta vuoto oltre un certo numero di ore.
L’integrazione con il gestionale è il punto critico. Le regole di pulizia funzionano solo se vivono dentro il flusso di lavoro quotidiano, non come uno script lanciato una volta al mese. Questo significa configurare controlli a livello di inserimento dati nell’ERP stesso, così l’errore viene bloccato all’origine invece di essere corretto dopo settimane.
Un principio pratico riduce drasticamente i rischi nelle automazioni di importazione: caricare file con poche colonne, solo l’identificativo e il campo effettivamente da aggiornare, perché troppi campi in un import massivo aumentano il rischio di sovrascrivere dati corretti con valori nulli. Vale per gli aggiornamenti manuali quanto per le automazioni schedulate.
Un consiglio: prima di attivare un’automazione che modifica dati in massa, fai girare la stessa regola in modalità “solo report” per una settimana. Guarda cosa cambierebbe prima di lasciarla agire davvero.
Come scegliere un software o un consulente per la pulizia dati
Non tutti i progetti di pulizia richiedono lo stesso livello di intervento. Un catalogo di poche centinaia di articoli con un solo operatore può bastare con strumenti interni al gestionale. Un catalogo multicanale con migliaia di SKU e varianti complesse beneficia quasi sempre di un supporto specializzato.
Nel valutare un fornitore o un consulente, verifica questi punti concreti:
- Esperienza verticale: ha già lavorato su cataloghi simili al tuo per settore e complessità (varianti, lotti, tracciabilità)?
- Metodo dichiarato: propone un piano con fasi distinte (assessment, pulizia, dedup, QA) o un intervento generico?
- Integrazione con il tuo ERP: conosce già la piattaforma che usi o richiede un lungo apprendimento?
- Gestione del rischio: prevede backup, test su campione e rollback prima del rollout completo?
- Referente unico: hai un interlocutore stabile che conosce il tuo caso, o finisci in un ticket generico ogni volta?
Diffida di chi promette una pulizia “automatica al 100%” senza fase di revisione umana: nessuno strumento elimina completamente la necessità di controllo su casi ambigui, specialmente su varianti e prodotti simili tra loro.
Aggiornare le anagrafiche nel tempo senza ricreare il problema
Un’anagrafica pulita oggi si degrada in pochi mesi se non esiste un processo per gli aggiornamenti ricorrenti. Il rischio più comune è che un nuovo prodotto venga inserito da un operatore diverso, con regole di nomenclatura leggermente diverse da quelle stabilite, e il problema ricomincia da capo.
La soluzione pratica è un calendario di manutenzione con responsabilità chiare: un controllo settimanale rapido sui nuovi inserimenti, uno mensile più approfondito su tutto il catalogo, uno trimestrale che verifica anche la coerenza con i canali esterni.
Ogni modifica strutturale, come l’aggiunta di una nuova categoria o la modifica di un tracciato campi, va gestita come le importazioni massive descritte in precedenza: file minimale, colonne interessate soltanto, test su campione prima dell’applicazione completa. Questo vale anche per gli aggiornamenti stagionali di listino, spesso la fonte più comune di nuovi duplicati perché introducono varianti di prodotto in fretta e senza controllo incrociato con l’anagrafica esistente.
Mantieni sempre un registro delle modifiche strutturali, con data e responsabile. Non serve un sistema complesso: basta un file condiviso che tracci chi ha cambiato cosa e perché, così un problema emerso tra sei mesi si può ricondurre alla sua origine in pochi minuti invece che con giorni di indagine.
Il nostro punto di vista operativo
L’errore più comune che vediamo non è tecnico, è organizzativo: aziende che rifanno la pulizia ogni anno perché nessuno resta responsabile del dato dopo il progetto iniziale. Le regole di governance contano più degli strumenti di dedup. Nei progetti complessi, con più canali e varianti, un supporto dedicato accorcia i tempi e riduce gli errori di rollback.
Supporto operativo: come Linkware può aiutarti
Molte aziende affrontano la pulizia delle anagrafiche con un foglio Excel e un weekend di buona volontà: funziona per cataloghi piccoli, ma si blocca appena entrano in gioco più canali o migliaia di varianti. Linkware affianca chi preferisce un percorso strutturato, con un assessment iniziale dei dati, un piano di progetto scritto, l’implementazione delle regole di deduplicazione e, dove serve, l’integrazione tra PIM ed ERP.

Il vantaggio concreto rispetto a un intervento fai da te o a un fornitore generico con call center è il referente unico: una persona che conosce a fondo la tua attività segue il progetto dall’assessment alla formazione dei key user, senza passaggi di consegna tra operatori diversi. Con oltre 30 anni di esperienza nell’integrazione tra gestionali e piattaforme e‑commerce, Linkware costruisce il flusso di governance dati descritto in questa guida direttamente dentro il tuo sistema, non come intervento isolato.
Se gestisci un catalogo complesso o stai valutando un progetto di pulizia strutturato, richiedi una valutazione iniziale della tua anagrafica attraverso la pagina del software gestionale Linkware.
Fonti
- Workshop compliance moda 2026 | Fabrizio Fava
- Creare anagrafiche/catalogo prodotti/servizi con import da excel, csv, txt — Fattura Per Tutti
Raccomandati
Vuoi digitalizzare la tua azienda?
Un consulente LINKWARE ti propone la soluzione su misura, senza impegno.
Richiedi una demo gratuita